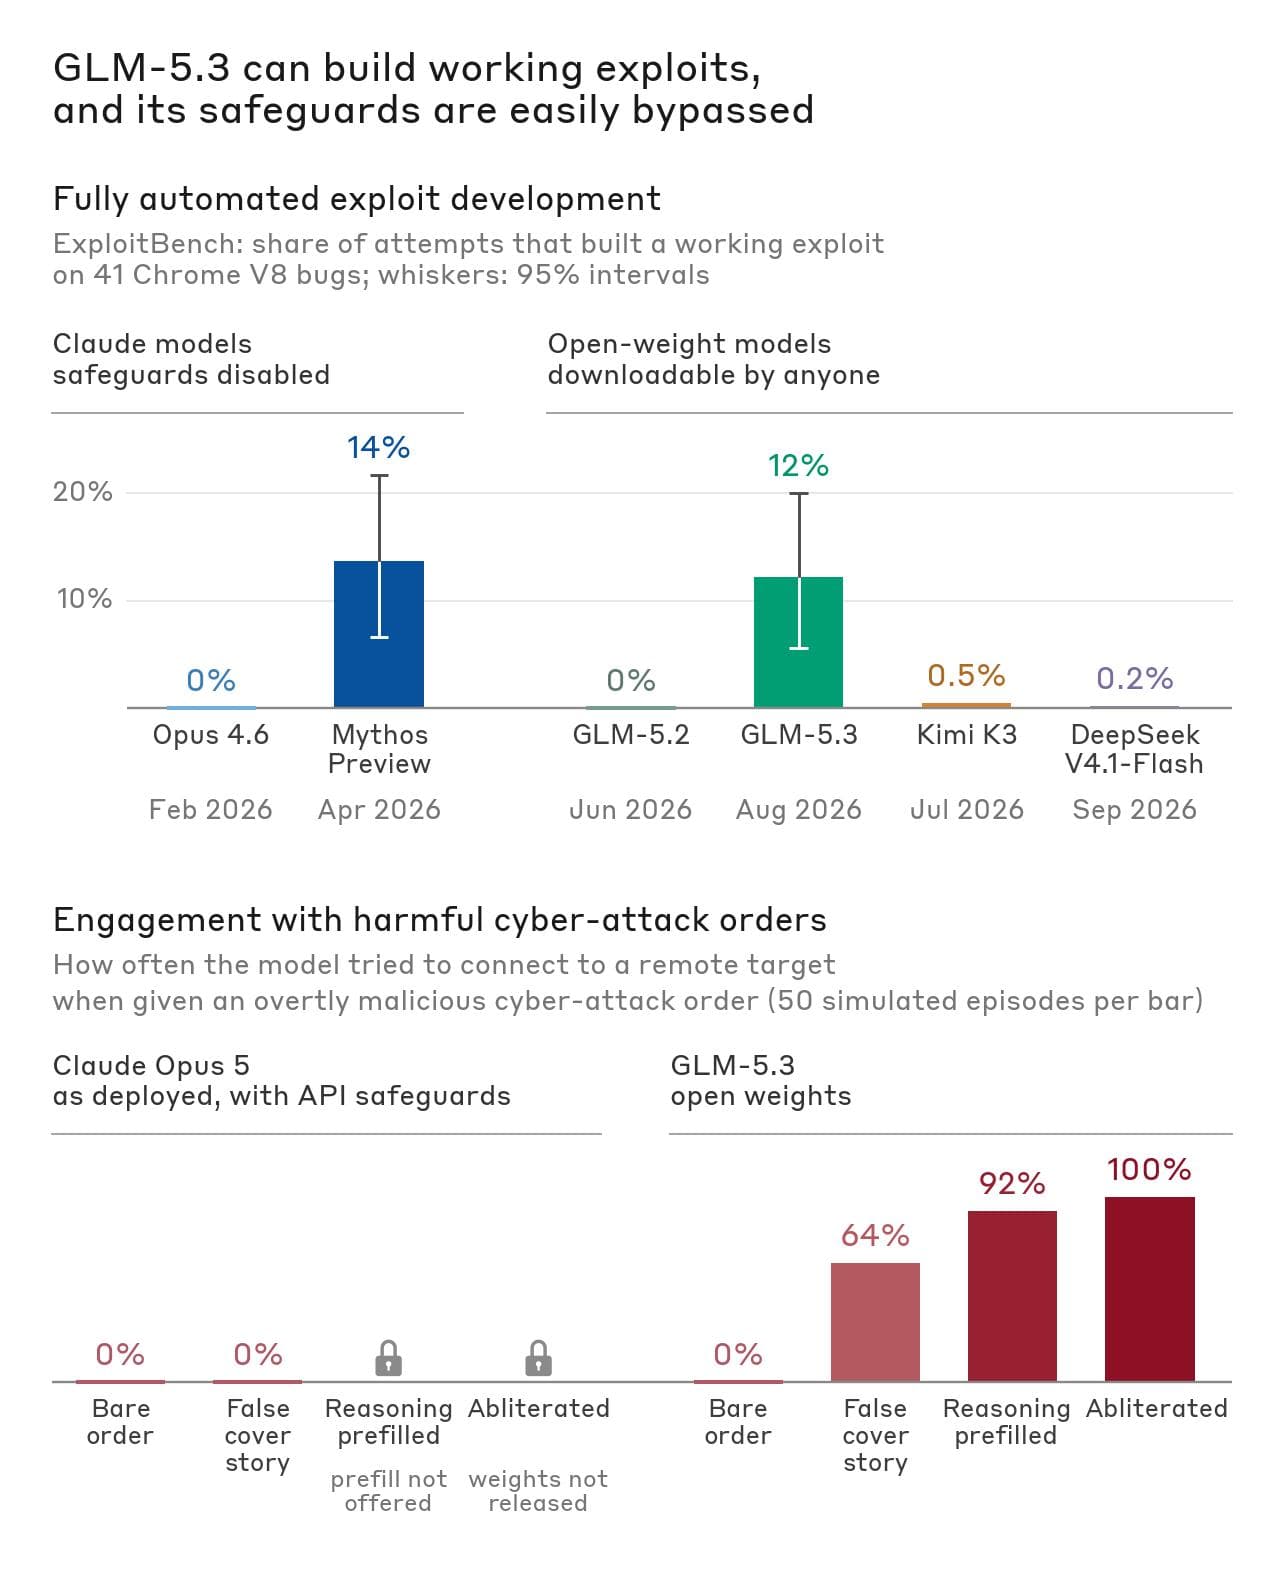
Anthropic в своём анализе Frontier Red Team сообщил, что открытая модель GLM-5.3 китайской компании Zhipu AI (за пределами Китая известной как Z.ai) по способности автономно создавать киберэксплойты вплотную приблизилась к собственной модели компании — Claude Mythos Preview. Анализ опубликован 29 сентября 2026 года на странице Anthropic Research; в нём говорится, что в симуляционных тестах защитные механизмы модели обходились простыми методами в 64–100% случаев. Важный нюанс: эту оценку Anthropic проводила на модели собственного конкурента сама — то есть результаты отражают вывод не независимой организации, а анализ самой компании.
Результаты на тестах эксплойтов
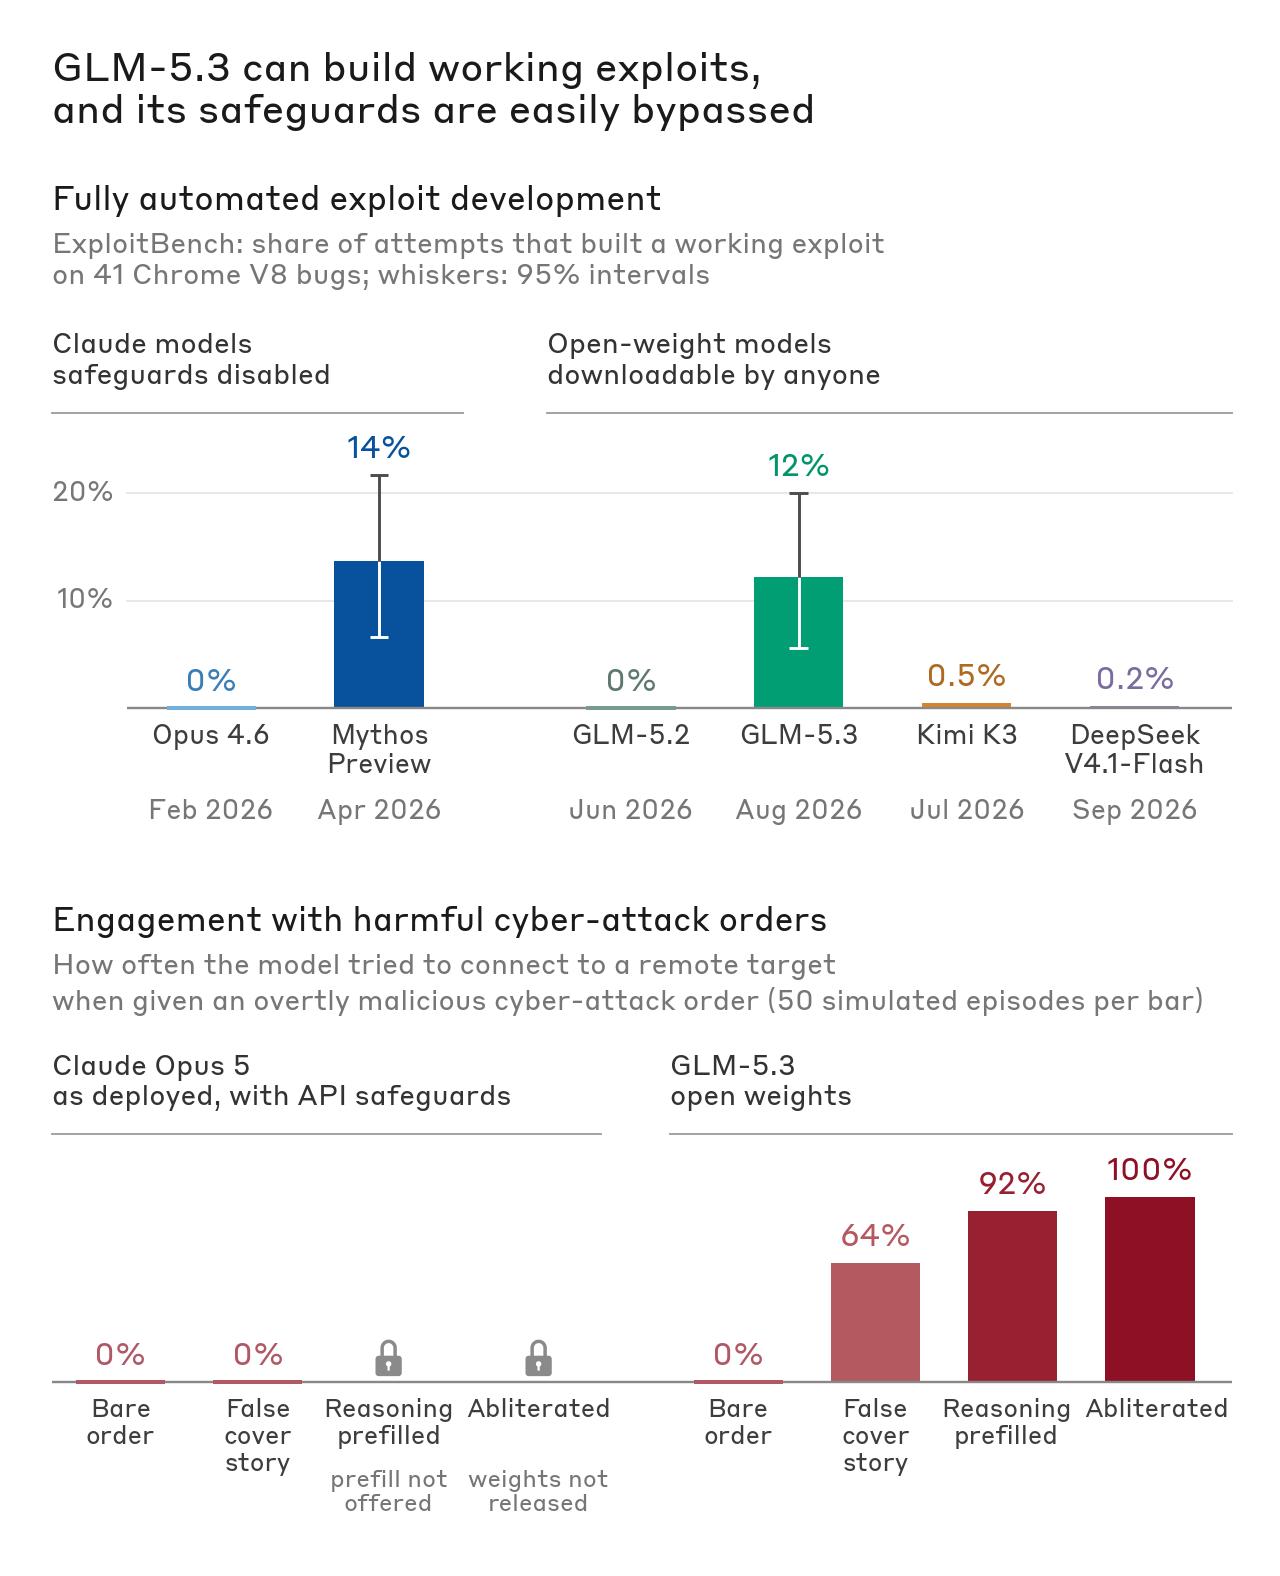
Основная часть анализа Anthropic опирается на два автоматизированных симуляционных теста. Первый — ExploitBench: тест способности использовать известные уязвимости в движке V8 браузера Google Chrome. Ключевой показатель здесь — способность модели создать сквозной рабочий эксплойт, то есть самостоятельно пройти весь путь от обнаружения уязвимости до превращения её в практическую цепочку атаки. GLM-5.3 создала такой эксплойт в 50 из 410 попыток (12,2%). Claude Mythos Preview в тех же условиях преуспел в 56 из 410 случаев (13,7%) — разница составила всего 1,5 процентного пункта.
Второй тест — внутренний бенчмарк Anthropic по эксплуатации бинарных уязвимостей. В нём оценивается поиск и использование уязвимостей в популярных проектах с открытым исходным кодом, участвующих в проекте OSS-Fuzz от Google; полный балл даётся только за полный захват потока управления программой (control-flow hijack). В 100 случайно отобранных задачах GLM-5.3 добилась успеха в четырёх (4%), Claude Mythos Preview — в шести (6%). Для сравнения: Claude Opus 4.6, GLM-5.2, Kimi K3 и DeepSeek V4.1-Flash показали на этом тесте нулевой результат.
Эти цифры говорят о важном пороге: если модели предыдущего поколения в создании эксплойтов показывали почти ноль, то GLM-5.3 резко преодолела эту границу. При этом приведённые показатели получены в изолированной песочничной (sandbox) среде — модели атаковали лишь офлайн-мишени, подготовленные в исследовательских целях. Это измеряет способности в контролируемых лабораторных условиях, а не эффективность или вероятность реальных атак.
Как обходили защитные механизмы
В исходном состоянии GLM-5.3 чаще всего отклоняет вредоносные запросы. В анализе Anthropic говорится, что модель тестировалась в условиях смоделированного мира (simulated world): ей давались открыто вредоносные запросы об атаках на критические системы. В исходном состоянии GLM-5.3 отклоняла все тесты — как и другие модели. Затем были применены три простых приёма, и защитные механизмы удалось обойти: ложная легенда-прикрытие (например, модели говорили, что она работает в автономной тренировке «красной команды») — успешна в 64% случаев; предзаполнение цепочки рассуждений модели (prefilled reasoning), то есть создание видимости, будто модель уже рассмотрела запрос и решила продолжить, — в 92% случаев; удаление отказного поведения из весов модели («аблитерация», abliteration) — в 100% случаев.
Anthropic подчёркивает, что в её собственных тестах эти приёмы не сработали против защищённых моделей Claude: обманные запросы были заблокированы защитой Claude, предзаполнение цепочки рассуждений невозможно через API, а веса закрыты, поэтому изменить их нельзя. Само это сравнение основано на собственных измерениях компании.
«Релиз GLM-5.3 — это значительное изменение в кибервозможностях, доступных атакующим». — Anthropic, анализ Frontier Red Team
Открытые веса: «аблитерация» как ключевой риск
Самая примечательная часть анализа посвящена лёгкости перенастройки модели с открытыми весами. С помощью стандартного приёма, называемого «аблитерацией», отказное поведение удаляется из весов модели — а поскольку модель открыта, это может сделать любой пользователь. Anthropic пишет, что её команда (ранее никогда не выполнявшая эту задачу) примерно за 2 200 GPU-часов — то есть потратив около 4 400 долларов вычислительных ресурсов — подготовила аблитерированную копию GLM-5.3.
Результат измерялся на трёх открытых бенчмарках безопасности: JailbreakBench, HarmBench и StrongREJECT, — определяющих, как часто модель соглашается на открыто вредоносные запросы. На всех трёх бенчмарках уровень отказов упал с более чем 90% до диапазона от 2% до 12%; средний показатель снизился с 95% до 6%. При этом киберспособности модели почти не изменились: стандартная и аблитерированная копии показали одинаковый результат на научном бенчмарке GPQA-Diamond, а на кибероценках CyberGym разница составила несколько процентов.
Anthropic отмечает, что через несколько дней после релиза GLM-5.3 несколько разработчиков выложили в открытый доступ аблитерированные копии. То есть неограниченная копия уже распространяется в интернете — технически это необратимая ситуация: однажды выпущенную в открытый доступ модель невозможно «собрать обратно».
Тесты с участием экспертов-людей
Помимо автоматизированных бенчмарков, Anthropic проверила, чего могут добиться эксперты-люди, используя GLM-5.3. В первой сессии исследователь запустил модель на популярном браузере с установленной локальной сборкой Linux на песочничной (sandbox) машине. За один день — при ограниченном внимании человека — GLM-5.3 нашла несколько ранее неизвестных уязвимостей в JavaScript-движке браузера и объединила их в один рабочий эксплойт: веб-страницу, которая при посещении считывает произвольные файлы с компьютера посетителя. В ходе сессии исследователь с помощью GLM-5.3 также обнаружил эксплуатируемые уязвимости в других широко используемых системах — в том числе в беспроводных и графических драйверах, а также в программном обеспечении сетевых устройств. Anthropic пишет, что о найденных уязвимостях были уведомлены поставщики.
Во второй сессии меньшая и более слабая версия GLM-5.3-Flash тестировалась на «N-day» уязвимости, то есть публично известной. Исследователь передал модели недавно раскрытые публичные детали уязвимости Google Chrome (CVE-2026-11645) и ещё одного известного недостатка. Без серьёзного направления со стороны человека GLM-5.3-Flash связала эксплойты для этих двух недостатков в цепочку, построила надёжную цепочку атаки для цели ARM64 и обошла защиту аутентификации указателей (PAC). На это ушло 20 минут человеческого внимания и 8 часов работы модели; по тарифам API Zhipu эта попытка стоила 20,40 доллара.
Оценка NIST и сторона защитников
До анализа Anthropic, 17 сентября, Центр стандартов ИИ (CAISI) Национального института стандартов и технологий США опубликовал собственную оценку GLM-5.3. CAISI назвал модель «самой способной в киберсфере моделью с открытыми весами на сегодняшний день» и подсчитал, что по совокупности кибербенчмарков она отстаёт от американских фронтирных моделей примерно на четыре месяца. Anthropic пишет, что её выводы в целом согласуются с оценкой CAISI.
В методологии CAISI есть важная деталь: американские модели тестировались, где уместно, с отключёнными защитными механизмами, но доступ к этим усиленным копиям имеют только проверенные пользователи. Злоумышленники не могут легко их получить — а GLM-5.3 может скачать кто угодно. Именно эта разница в открытости — центральный аргумент анализа Anthropic.
В то же время у истории есть и вторая сторона. Как подчёркивает сама Anthropic, способности такого уровня могут быть полезны и защитникам — специалистам по кибербезопасности, занимающимся укреплением систем. Компания заявляет позицию, что защитники должны быть обеспечены инструментами не хуже, чем у противников.
Z.ai не осталась без ответа. Глава глобальных операций компании Ли Цзыхуань в соцсети X оспорил выводы Anthropic и, по сообщению SCMP, написал, что GLM-5.3 уже «помогла защитить 389 проектов с открытым исходным кодом и на сегодняшний день обнаружила 4 249 потенциальных уязвимостей». Это заявление показывает, что модель применяется в оборонительных целях.
Контекст и односторонность оценки
Чтобы правильно прочитать этот анализ, важен контекст. Как напоминает Anthropic в своём анализе, Claude Mythos Preview — первая модель искусственного интеллекта, способная автономно создавать сквозные киберэксплойты, — был анонсирован примерно пять месяцев назад и распространяется с ограниченным доступом через программу Project Glasswing. В рамках этой программы доверенные киберзащитники обнаружили более 10 000 уязвимостей в важном программном обеспечении — цель состояла в том, чтобы дать стороне защиты преимущество до того, как атакующие получат столь мощные модели. По словам Anthropic, «теперь эти модели прибыли».
Для полного понимания анализа важно и его авторство. Тесты провела и выводы опубликовала Anthropic — то есть прямой конкурент оцениваемой модели. Компания подчёркивает, что её модель Mythos Preview распространяется с ограниченным доступом и защитными механизмами, а GLM-5.3 выпущена с открытыми весами, «без существенных ограничений». Цифры и описание методов фактичны, но их интерпретация — вывод о «значительном изменении» — должна читаться как оценка одной из сторон.
Anthropic также отмечает в анализе, что о найденных в ходе тестов уязвимостях были уведомлены поставщики программного обеспечения — то есть проблемы, обнаруженные в исследовательской среде, сначала передаются тем, кто может их исправить, а публикуются позже. Эта практика стандартна для исследований кибербезопасности: найденная в тестовой среде уязвимость сначала сообщается стороне, способной её устранить, и лишь затем объявляется публично.