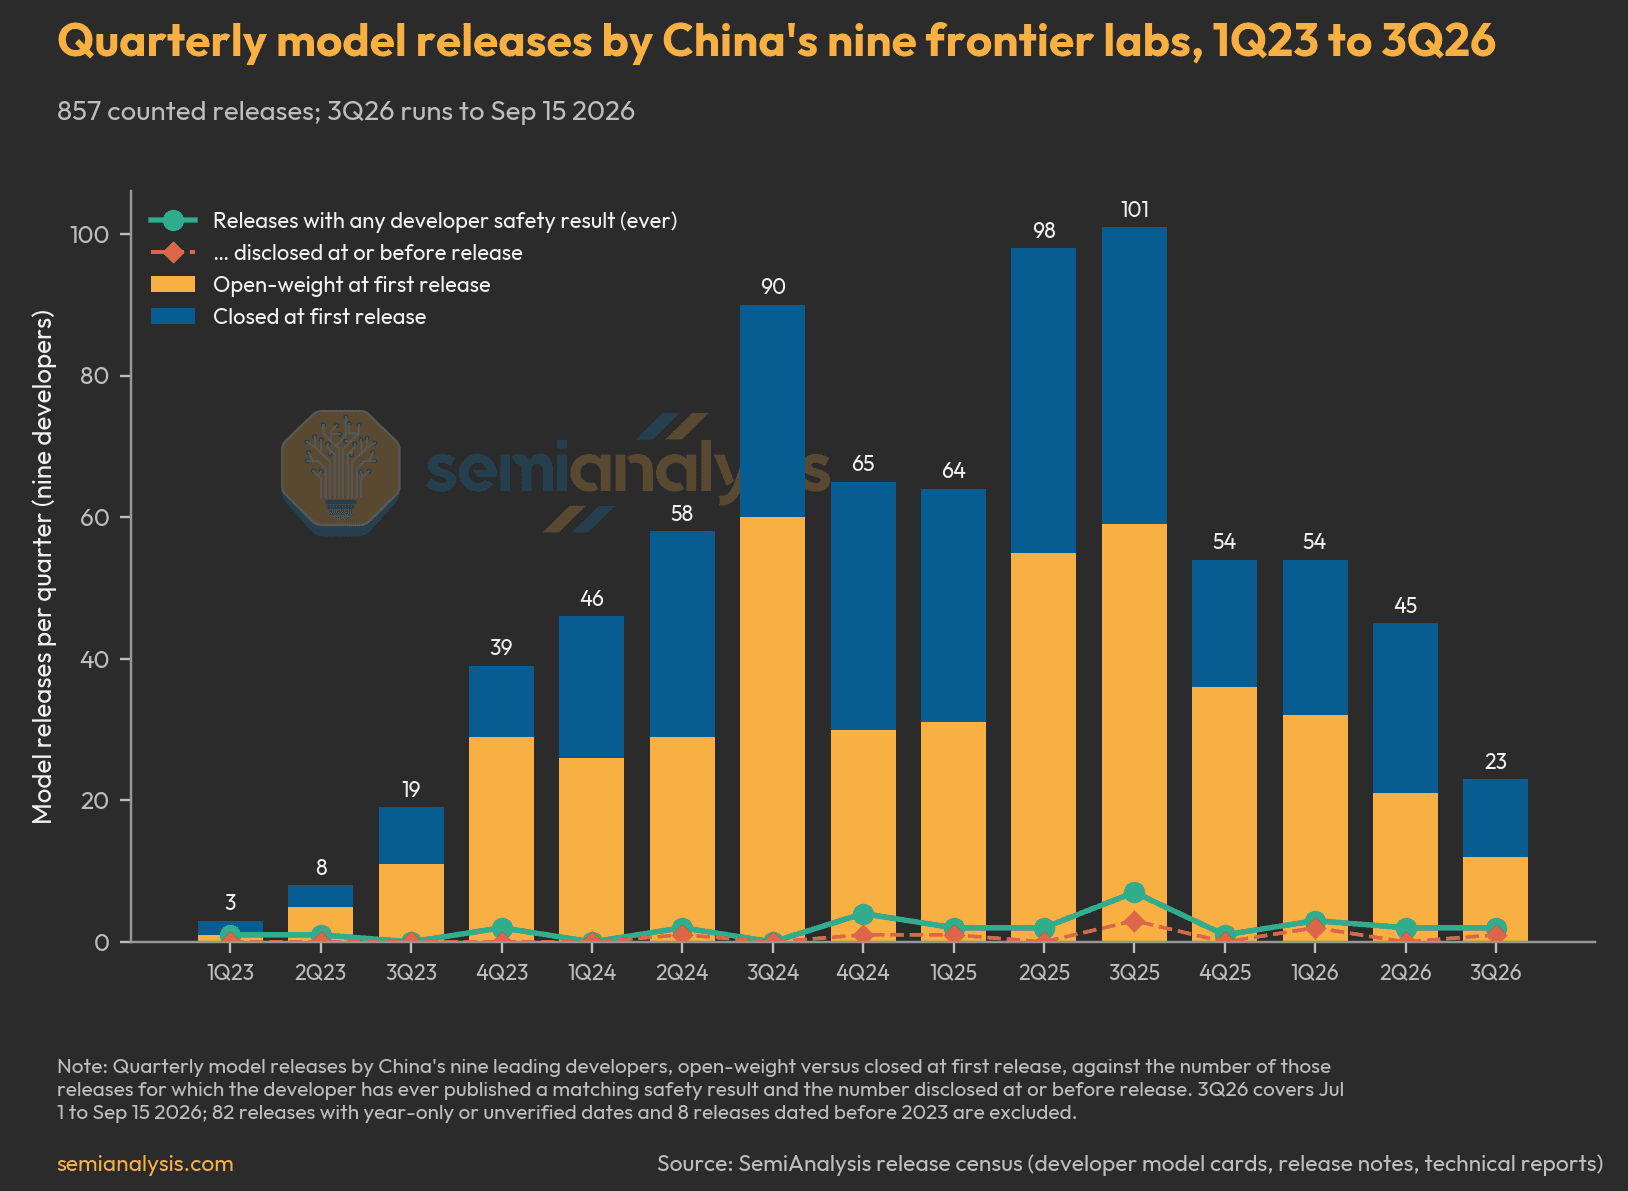
Reuters 9 октября 2026 года сообщило, что исследовательская фирма SemiAnalysis проанализировала 857 релизов моделей, выпущенных девятью ведущими китайскими разработчиками искусственного интеллекта в период с 2021 года по 15 сентября 2026 года, и выяснила: лишь в 31 случае (3,6%) были публично раскрыты результаты оценки безопасности, привязанные к конкретной модели. Только 9 из них (1,1%) вышли в свет одновременно с релизом или раньше; по оставшимся 813 релизам никаких данных о безопасности раскрыто не было.
Как проводилось исследование
В исследование вошли Alibaba, ByteDance, Tencent, Baidu, DeepSeek, Moonshot, Z.AI, MiniMax и StepFun — четыре крупных технологических гиганта и пять стартапов. Каждый релиз сверялся с модельной картой, примечаниями к релизу и техническими отчётами разработчика.
Период исследования охватывает более пяти лет — с 2021 года по 15 сентября 2026 года; за это время девять компаний выпустили модели в общей сложности 857 раз.
Методология подсчёта была строгой: исследователи учитывали только публично опубликованные конкретные результаты, привязанные к чётко названной модели. Сюда входят выводы о вредоносных выходных данных, устойчивости к обходу защитных механизмов, токсичности, конфиденциальности, поведении при отказе от ответа на запрос и опасных возможностях. Общие заявления вроде «модель обучена с учётом безопасности» или «оценена» не учитывались — принимались только результаты с конкретными выводами или цифрами.
Чтобы результат был засчитан, он должен был относиться именно к этой модели и содержать конкретный вывод или цифру — такой критерий автоматически исключил общие утверждения вроде «обучен с учётом безопасности» или «оценён». Исследователи проверяли каждый релиз по модельной карте, примечаниям к релизу и техническим отчётам разработчика по отдельности.
Цифры за 3,6%
Из 857 релизов результаты безопасности, привязанные к конкретной модели, найдены лишь в 31 — это 3,6% всех релизов. Лишь в 9 из них результат опубликован одновременно с релизом или раньше, то есть доля релизов с оценкой безопасности на момент выхода не превышает 1,1%. Оставшиеся 813 релизов — 94,9% всех релизов — не содержат никаких опубликованных разработчиком результатов безопасности. Иначе говоря, лишь примерно каждый 28-й релиз сопровождался публично раскрытым результатом безопасности по конкретной модели, а моделей, результат по которым вышел одновременно с релизом или раньше, — примерно одна на каждые сто релизов.
Полное распределение таково: из 31 результата 9 опубликованы одновременно с релизом или раньше, 16 задокументированы после релиза (медианная задержка — 42 дня), для 6 время выхода или привязка к конкретной модели не установлены; ещё в 10 релизах есть заявление об оценке без цифр, в 3 — только пресса или информация для инвесторов, а в оставшихся 813 — вообще никакого раскрытия.
Таким образом, даже из раскрытых 31 результата 16 были задокументированы с опозданием после релиза (медианная задержка — 42 дня), а по 6 время или привязка к модели вообще не установлены — то есть в большинстве случаев, когда раскрытие было, пользователь не мог увидеть оценку безопасности модели в момент её выхода.
Ещё один вывод отчёта: ни один крупный китайский разработчик не выпустил ведущую текстовую модель с открыто опубликованными результатами тестов опасных возможностей, охватывающих кибернетические, биологические риски и риски потери контроля. То есть о самых опасных, по мнению экспертов, возможностях топовых моделей никогда не сообщалось, что они прошли открытое тестирование.
«Реальный подход Китая к безопасности искусственного интеллекта основан не на безопасности, а на скорости», — пришли к такому выводу исследователи SemiAnalysis в своём отчёте.
Китайское регулирование: приложения под контролем, граница моделей открыта
По данным SemiAnalysis, китайская система регулирования безопасности ИИ признаёт ведущие риски, но не устанавливает обязательных требований, связанных с возможностями моделей. То есть в официальных документах риски перечислены, однако они автоматически не накладывают на разработчика обязательств в зависимости от размера или возможностей модели.
Обязательные же правила Пекина регулируют в основном приложения и их воздействие на пользователей: под контролем то, что выходит, и как это влияет на людей, но не требуется, как именно модель должна тестироваться и раскрываются ли результаты. Главный вывод отчёта вытекает из этого: китайский режим жёсткий на уровне приложений, но работает без обязательных границ на уровне ведущих моделей.
Практически это означает, что жёсткий контроль на уровне приложений не может компенсировать отсутствие обязательных границ на уровне самых продвинутых моделей — авторы отчёта описывают китайский режим именно так: жёсткий на уровне приложений, но без обязательных границ на уровне ведущих моделей.
Сравнение с американскими лабораториями
В отчёте не приводятся сопоставимые цифры по американским разработчикам — SemiAnalysis посчитала релизы только китайских компаний, такого же полного подсчёта для американских лабораторий не проводила. Поэтому прямое сравнение двух сторон в цифрах невозможно. Однако, как отмечает Reuters, OpenAI, Anthropic и Google DeepMind при выпуске некоторых крупных ведущих моделей публиковали отчёты о безопасности, системные карты или модельные карты. То есть некоторые западные лаборатории имеют практику открытого опубликования документов по безопасности в самых важных релизах, а у китайских разработчиков такой практики систематически нет.
Это различие видно не в цифрах, а в практике: некоторые западные лаборатории имеют практику открытого опубликования документов по безопасности в своих самых важных релизах, а у китайских разработчиков такая практика не является системной.
SemiAnalysis опубликовала оригинальное исследование 8 октября 2026 года под названием «Beijing Will Not Pace the Frontier: China's Speed-First AI Safety Regime». Основной тезис отчёта отражён уже в его названии: авторы называют реальный подход Китая к безопасности ИИ основанным на скорости. Reuters осветил результаты исследования на следующий день, 9 октября.