15 октября 2026 года NVIDIA в официальном блоге представила три новые открытые модели семейства Nemotron. Главная модель — Nemotron 3.5 Super VL со 120 миллиардами параметров, предназначенная для постоянно работающих агентов. Новые модели охватывают все уровни развёртывания агентов — от корпоративных серверов до персональных компьютеров и периферийных устройств. Её дополняют две периферийные модели: Nemotron 3.5 Bolt 74B-A9B 24GB — для локального выполнения агентских задач на системах NVIDIA RTX и DGX Spark. Super VL и Bolt 74B-A9B стали доступны в день анонса, а Bolt E4B 4GB выйдет 23 октября 2026 года. Все три модели распространяются с открытыми весами, открытыми наборами данных и рецептами обучения. Сначала NVIDIA подробно рассказала о моделях в официальном блоге 15 октября, а 19 октября TechCrunch донес релиз до более широкой аудитории.
Super VL: передовая точность и пятикратная скорость
Nemotron 3.5 Super VL показывает почти такую же точность, как крупнейшая рассуждающая модель NVIDIA, при примерно в пять раз меньшем числе параметров. По данным компании, модель демонстрирует лучшую в своём классе точность в мультимодальных агентских задачах — следовании инструкциям, использовании инструментов, многошаговых бизнес-процессах и визуальном понимании. Под мультимодальными агентскими задачами понимается способность модели понимать изображения и интерфейсы наряду с текстом и действовать на их основе — например, прочитать таблицу в документе и спланировать следующий шаг на её основе.
Super VL обеспечивает лучшую точность в мультимодальных агентских задачах — следовании инструкциям, использовании инструментов, многошаговых бизнес-процессах и визуальном понимании; этот результат достигнут при примерно в пять раз меньшем числе параметров, чем у крупнейшей рассуждающей модели NVIDIA. (Источник: блог NVIDIA)
Кроме того, NVIDIA называет Super VL самой быстрой открытой агентской моделью в своём классе: по результатам рейтинга Artificial Analysis Intelligence Index она обеспечивает до пяти раз более высокую пропускную способность по сравнению с другими моделями класса. Это позволяет значительно быстрее выполнять высоконагруженные агентские рабочие процессы — задачи, длящиеся дни или недели. Скорость — решающий показатель для агентов: выполняя многошаговую задачу, агент обращается к модели десятки, а порой и сотни раз, поэтому любой выигрыш в пропускной способности напрямую влияет на общее время выполнения задачи. Именно поэтому NVIDIA подчёркивает, что Super VL предназначена для постоянно работающих агентов.
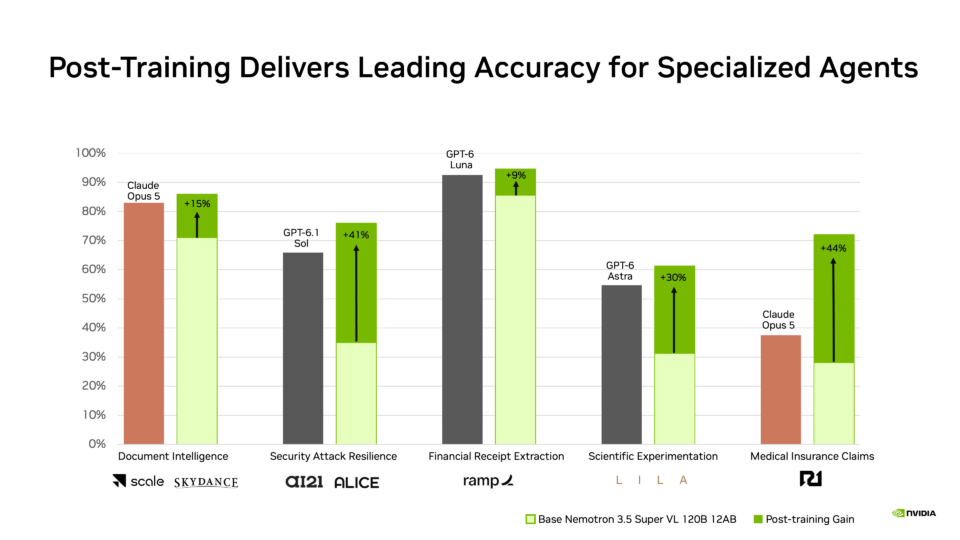
Модель прошла предварительное обучение на примерно 26 триллионах токенов, затем — дополнительное обучение (post-training) на примерно 3,8 миллиона примеров, с применением обучения с подкреплением (reinforcement learning) в десятках сред. Открытость рецептов обучения позволяет организациям воспроизводить и адаптировать модель на собственных данных — это уровень прозрачности, недоступный закрытым моделям.
Bolt: агентский интеллект теперь на локальных устройствах
По данным TechCrunch, Nemotron 3.5 Bolt 74B-A9B 24GB создан для локального выполнения повседневных агентских задач. Благодаря локальному 2-битному квантованию (quantization) она помещается в 24 ГБ памяти и может работать бок о бок с другими приложениями. 2-битное квантование — метод снижения точности весов модели, сокращающий потребление памяти при максимально возможном сохранении качества. По заявлению NVIDIA, она является лучшей открытой моделью в своём классе в рейтинге PinchBench.
Она работает на компьютерах GeForce RTX и системах DGX Spark — то есть пользователи с таким оборудованием могут запускать агентов локально, не обращаясь к облаку. Локальная работа даёт два практических преимущества: запросы не покидают устройство, поэтому сохраняется конфиденциальность данных, а задержки минимальны. Агент продолжает работать даже при отключении интернета. Bolt E4B 4GB — вторая модель линейки Bolt для периферийных устройств — выйдет 23 октября.
Кто уже адаптирует модель
Среди организаций, уже адаптирующих модель, — Scale AI, Ramp, Atlassian, CrowdStrike, Dassault Systèmes, Perplexity и Salesforce. Scale AI адаптировала модель для финансового агента Skydance по кредиту поставщика и агента EY по проверке сделок слияния и поглощения (M&A due diligence).
Принцип открытых весов позволяет организациям запускать модель в собственной инфраструктуре в соответствии со своими требованиями к безопасности и размещению данных. Они выбирают открытую модель, которую могут адаптировать сами, вместо закрытых альтернатив, зависящих от ограничений поставщика. Открытый выпуск NVIDIA всех трёх моделей — с весами, наборами данных и рецептами — стал ещё одним серьёзным шагом в развитии открытой экосистемы в корпоративном сегменте.