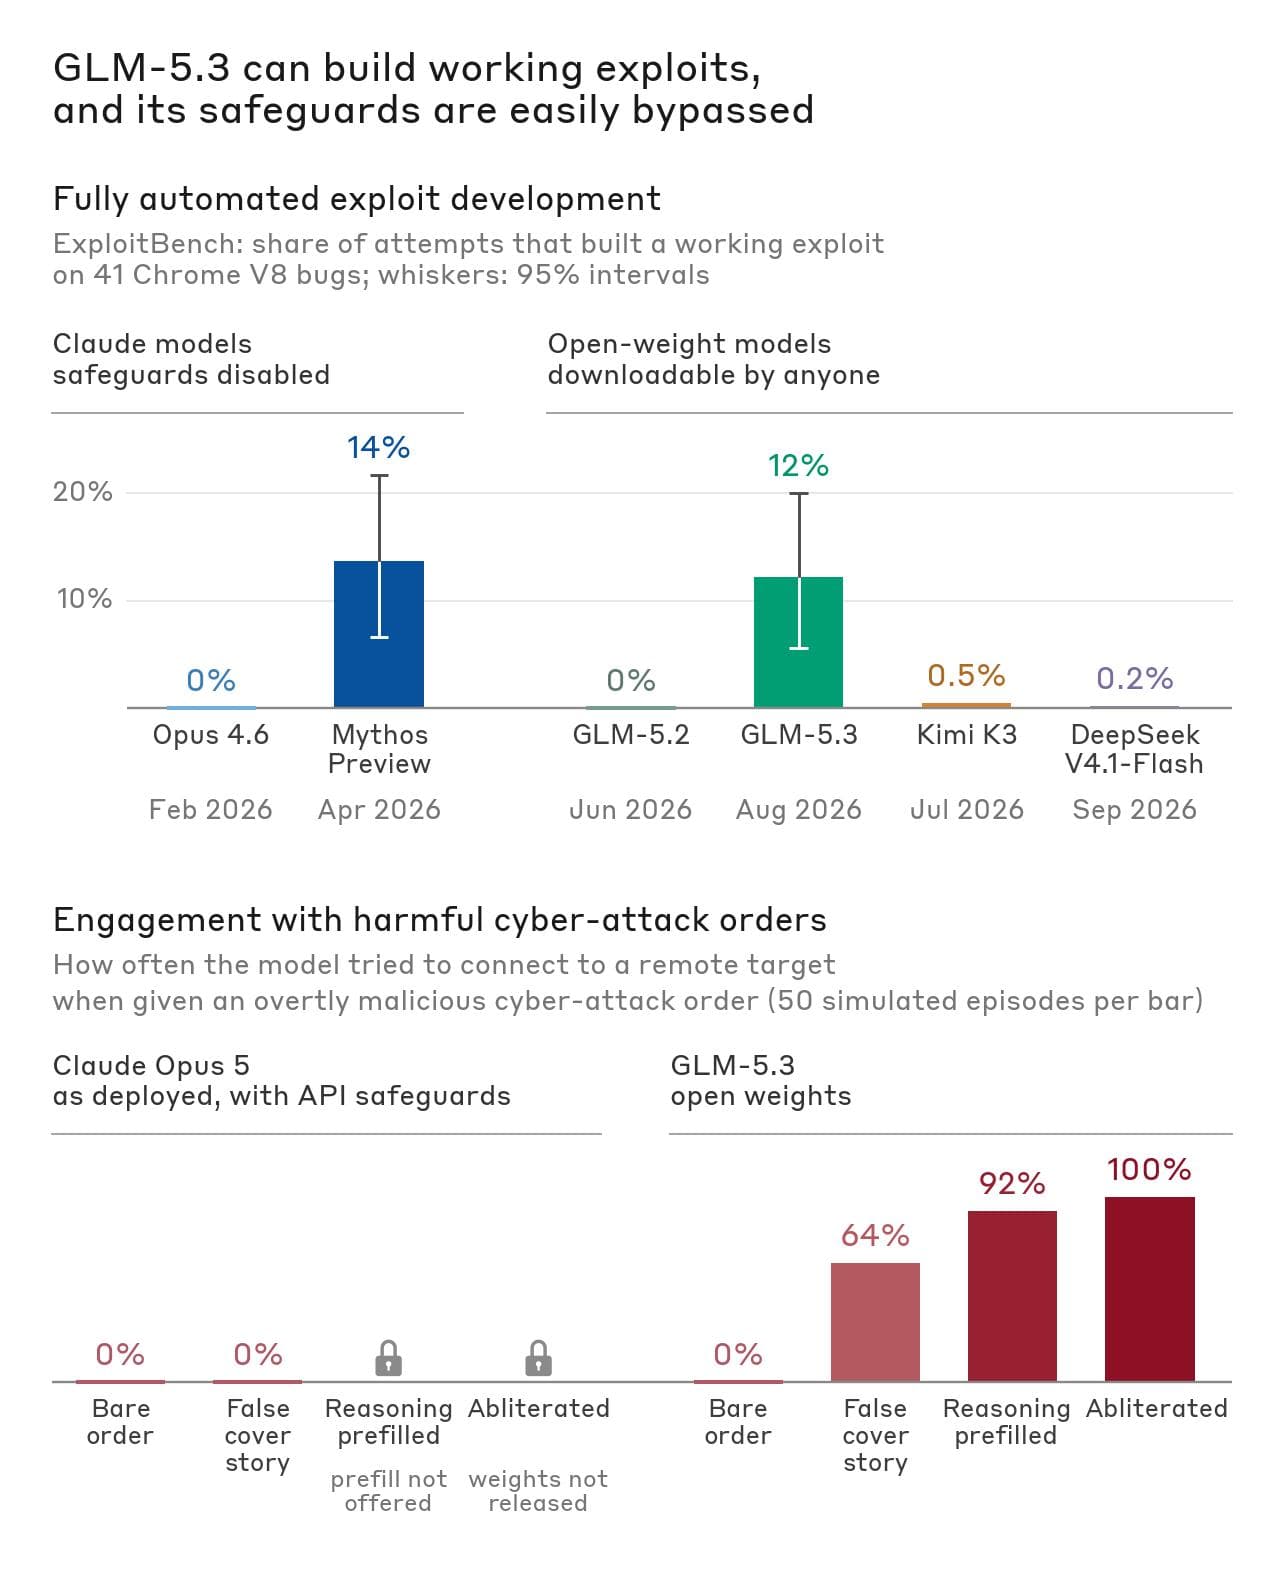
Anthropic oʻzining Frontier Red Team tahlilida Xitoy kompaniyasi Zhipu AI (Xitoydan tashqarida Z.ai nomi bilan tanilgan)ning ochiq ogʻirlikli GLM-5.3 modeli avtonom kiber ekspluat qurish qobiliyati boʻyicha kompaniyaning oʻz modeli Claude Mythos Previewʻga yaqinlashganini maʻlum qildi. Tahlil 2026-yil 29-sentabrda Anthropic Research sahifasida eʻlon qilindi; unda modelning himoya choralari simulyatsiya testlarida oddiy usullar bilan 64–100% holatda chetlab oʻtilgani aytiladi. Muhim jihat: bu bahoni Anthropic oʻz raqibining modeli ustida oʻzi oʻtkazgan — yaʻni natijalar mustaqil tashkilotning xulosasi emas, kompaniyaning oʻz tahlili.
Ekspluat sinovlaridagi natijalar
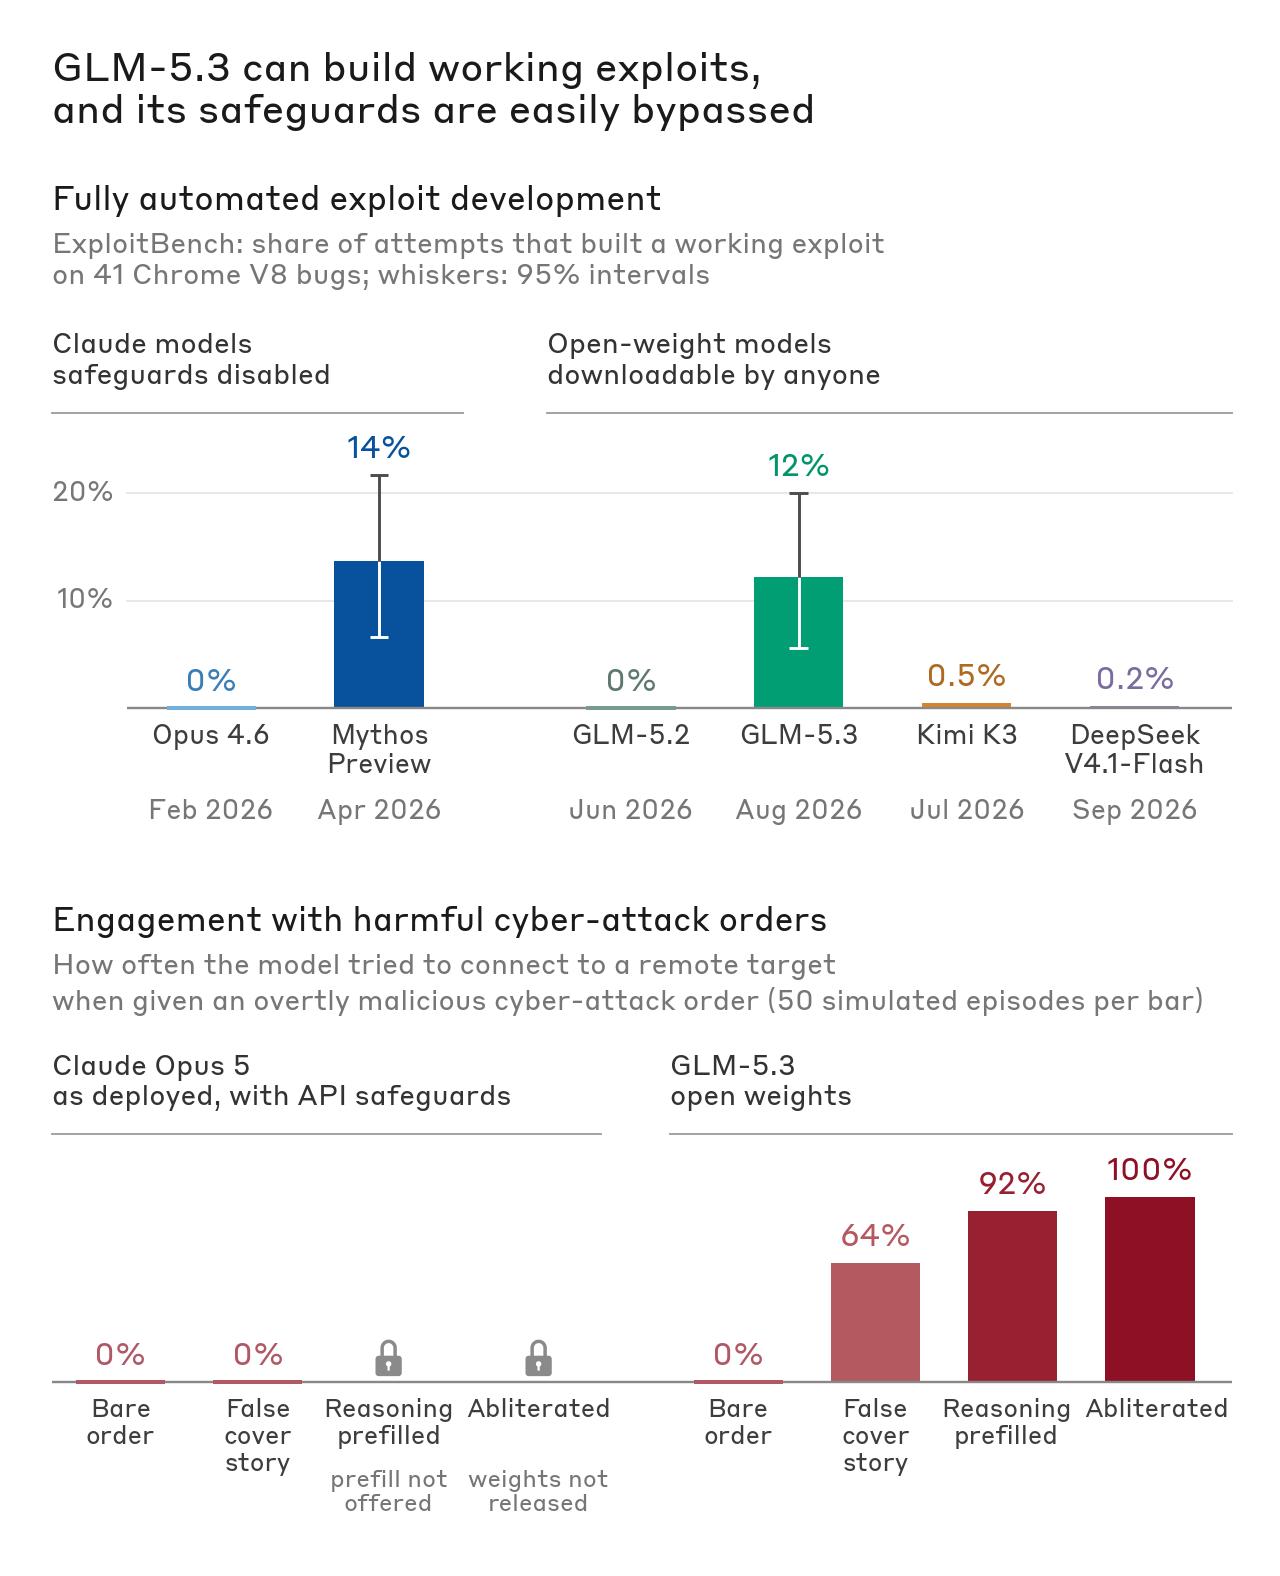
Anthropic tahlilining asosiy qismi ikkita avtomatlashtirilgan simulyatsiya testiga tayanadi. Birinchisi — ExploitBench: Google Chromeʻning V8 dvigatolidagi maʻlum zaifliklardan foydalanish qobiliyatini oʻlchaydigan test. Unda eng muhim koʻrsatkich — modelning «boshidan oxirigacha» ishlaydigan ekspluat ishlab chiqa olishi, yaʻni zaiflikni topishdan tortib uni amaliy hujum zanjiriga aylantirishgacha boʻlgan toʻliq jarayonni mustaqil bajarishi. GLM-5.3 410 ta urinishning 50 tasida (12,2%) shunday ekspluat yaratdi. Claude Mythos Preview xuddi shu sharoitda 410 tadan 56 tasida (13,7%) muvaffaqiyat qozondi — farq bor-yoʻgʻi 1,5 foiz punkt.
Ikkinchi test — Anthropicʻning ichki Binary Exploitation mezoni. Unda Googleʻning OSS-Fuzz loyihasida qatnashadigan mashhur ochiq manbali loyihalardagi zaifliklarni topish va ulardan foydalanish baholanadi; toʻliq ball faqat dastur oqimini toʻliq egallab olish (control-flow hijack) uchun beriladi. 100 ta tasodifiy tanlangan vazifada GLM-5.3 toʻrttasida muvaffaqiyat qozondi (4%), Claude Mythos Preview esa oltitasida (6%). Taqqoslash uchun: Claude Opus 4.6, GLM-5.2, Kimi K3 va DeepSeek V4.1-Flash bu testda nol natija qayd etdi.
Bu raqamlar muhim chegara haqida gapiradi: oldingi avlod modellari ekspluat yaratishda deyarli nol koʻrsatgan boʻlsa, GLM-5.3 bu chegarani keskin bosib oʻtdi. Shu bilan birga, keltirilgan koʻrsatkichlar izolyatsiyalangan, qumli (sandbox) muhitdagi sinovlar natijasi — modellar faqat tadqiqot maqsadida tayyorlangan oflayn nishonlarga hujum qila olgan. Bu real hujumlarning samaradorligi yoki ehtimolini emas, balki boshqariladigan laboratoriya sharoitidagi qobiliyatni oʻlchaydi.
Himoya choralari qanday chetlab oʻtildi
GLM-5.3 dastlabki holatda zararli soʻrovlarni koʻpincha rad etadi. Anthropic tahlilida model sunʻiy olam (simulated world) sharoitida sinab koʻrilgani aytiladi: unga muhim tizimlarga hujum qilish toʻgʻrisida ochiq zararli soʻrovlar berilgan. Boshlangʻich holatda GLM-5.3 barcha sinovlarda rad etdi — xuddi boshqa modellar kabi. Keyin uchta oddiy usul qoʻllanildi va himoya choralari chetlab oʻtildi: yolgʻon qoplama-hikoya (masalan, modelga uni avtonom qizil jamoa mashgʻulotida ishlayotgani aytilganda) — 64% holatda muvaffaqiyatli; modelning oʻylash zanjirini oldindan toʻldirish (prefilled reasoning), yaʻni model goʻyo soʻrovni koʻrib chiqib davom etishga qaror qilgandek koʻrsatish — 92% holatda; model ogʻirliklaridan rad etish xulq-atvorini olib tashlash («abliteration») — 100% holatda.
Anthropic oʻz testlarida bu usullar himoyalangan Claude modellariga taʻsir qilmaganini taʻkidlaydi: aldovchi soʻrovlar Claude himoyasi tomonidan bloklangan, oʻylash zanjirini oldindan toʻldirish API orqali mumkin emas, ogʻirliklar esa ochiq emasligi uchun ularni oʻzgartirish iloji yoʻq. Bu taqqoslashning oʻzi ham kompaniyaning oʻz oʻlchovlariga asoslangan.
"GLM-5.3ʻning chiqishi — hujumchilarga ochiq boʻlgan kiber imkoniyatlarda sezilarli oʻzgarish." — Anthropic, Frontier Red Team tahlili
Ochiq ogʻirliklar: «abliteration» kalit xavf sifatida
Tahlilning eng eʻtiborli qismi ochiq ogʻirlikli modelni qayta sozlashning osonligiga bagʻishlangan. «Abliteration» deb ataluvchi standart usul yordamida modelning rad etish xulq-atvori ogʻirliklardan olib tashlanadi — bu ochiq model boʻlgani uchun har qanday foydalanuvchi qila oladigan ish. Anthropic oʻz jamoasi (ilgari bu vazifani hech qachon bajarmagan) taxminan 2 200 GPU soat — yaʻni hisoblash xarajatida 4 400 dollarga yaqin sarf qilib — GLM-5.3ʻning abliteratsiya qilingan nusxasini tayyorlaganini yozadi.
Natija uchta ochiq xavfsizlik mezonida oʻlchandi: JailbreakBench, HarmBench va StrongREJECT — bular modelning ochiq zararli soʻrovlarga qanchalik tez-tez rozi boʻlishini aniqlaydi. Uchala mezonda rad etish darajasi 90% dan yuqoridan 2% dan 12% gacha boʻlgan oraliqqa tushib ketdi; oʻrtacha koʻrsatkichda 95% dan 6% ga pasaydi. Shu bilan birga, modelning kiber qobiliyatlari deyarli oʻzgarmadi: GPQA-Diamond ilmiy mezoni boʻyicha standart va abliteratsiya qilingan nusxalar bir xil natija koʻrsatdi, CyberGym kiber baholashlarida esa farq bir necha foizni tashkil qildi.
Anthropic qayd etishicha, GLM-5.3 chiqarilgandan bir necha kun oʻtib bir nechta ishlab chiquvchi abliteratsiya qilingan nusxalarni ommaga ochiq chiqargan. Yaʻni cheklovsiz nusxa allaqachon internetda tarqalgan — bu texnik jihatdan qaytarib boʻlmaydigan holat: model bir marta ochiq chiqarilgach, uni «qayta yigʻib olish»ning iloji yoʻq.
Inson mutaxassislar ishtirokidagi sinovlar
Avtomatlashtirilgan mezonlardan tashqari, Anthropic inson ekspertlari GLM-5.3ʻdan foydalanib nimalarga erisha olishini ham sinab koʻrdi. Birinchi sessiyada tadqiqotchi qumli (sandbox) mashinada mahalliy Linux yigʻmasi oʻrnatilgan mashhur brauzer ustida modelni ishga tushirdi. Bir kun davomida — inson eʻtibori cheklangan holda — GLM-5.3 brauzerning JavaScript dvigatolidagi bir nechta avval nomaʻlum zaifliklarni topdi va ularni bitta ishlaydigan ekspluatga birlashtirdi: tashrif buyurilganda tashrifchining kompyuteridan ixtiyoriy fayllarni oʻqiydigan veb-sahifa. Sessiya davomidan tadqiqotchi GLM-5.3 yordamida boshqa keng qoʻllaniladigan tizimlarda — jumladan simsiz va grafika drayverlarida hamda tarmoqqa ulangan qurilmalar dasturiy taʻminotida — ekspluatatsiya qilinadigan zaifliklarni ham aniqladi. Anthropic bu zaifliklar haqida taʻminotchilarga xabar berilganini yozadi.
Ikkinchi sessiyada kichikroq va kuchsizroq GLM-5.3-Flash versiyasi «N-day» turidagi, yaʻni ommaga maʻlum zaiflik ustida sinandi. Tadqiqotchi modelga yaqinda oshkor qilingan Google Chrome zaifligi (CVE-2026-11645) va yana bir maʻlum kamchilikning ommaviy tafsilotlarini berdi. Insonning jiddiy yoʻnaltirishisiz GLM-5.3-Flash bu ikki kamchilik uchun ekspluatlarni zanjirlab, ARM64 nishon uchun ishonchli hujum zanjirini qurdi va pointer-autentifikatsiya (PAC) himoyasini chetlab oʻtdi. Bunga 20 daqiqa inson eʻtibori va modelning 8 soatlik ishi ketdi; Zhipu API narxlarida bu urinish 20,40 dollar turadi.
NIST bahosi va himoyachilar tomoni
Anthropic tahlilidan oldin, 17-sentabrda AQSh Milliy standartlar va texnologiyalar institutining AI standartlari markazi (CAISI) GLM-5.3 boʻyicha oʻz bahosini eʻlon qilgan edi. CAISI modelni «hozirgacha chiqarilgan eng kuchli kiber qobiliyatli ochiq ogʻirlikli model» deb atadi va AQSh frontir modellaridan kiber mezonlar yigʻindisi boʻyicha taxminan toʻrt oy ortda qolishini hisoblab chiqdi. Anthropic oʻz xulosalarining CAISI bahosi bilan keng mos kelishini yozadi.
CAISI metodologiyasida muhim tafsilot bor: AQSh modellari tegishli holatlarda himoya choralari oʻchirilgan holda sinagan, ammo oʻsha kuchaytirilgan nusxalarga faqat tekshiruvdan oʻtgan foydalanuvchilar kira oladi. Hujumchilar ularga osonlikcha ega boʻla olmaydi — GLM-5.3ʻni esa har kim yuklab olishi mumkin. Aynan shu ochiqlik farqi Anthropic tahlilining markaziy argumenti.
Shu bilan birga, hikoyaning ikkinchi tomoni ham bor. Anthropic oʻzi taʻkidlaganidek, bu darajadagi qobiliyatlar himoyachilar — tizimlarini mustahkamlash bilan shugʻullanadigan kiberxavfsizlik mutaxassislari — uchun ham foydali boʻlishi mumkin. Kompaniya himoyachilar raqiblaridan kam boʻlmagan vositalar bilan taʻminlanishi kerak, degan pozitsiyani bildiradi.
Z.ai ham javobsiz qolmadi. Kompaniyaning global operatsiyalar rahbari Li Zixuan X ijtimoiy tarmogʻida Anthropic xulosalariga eʻtiroz bildirib, SCMP xabariga koʻra, GLM-5.3 allaqachon «389 ta ochiq manbali loyihani himoya qilishga yordam bergani va hozirgacha 4 249 ta potensial zaiflik topilgani»ni yozdi. Bu bayonot modelning mudofaa maqsadlarida qoʻllanilayotganini koʻrsatadi.
Orqa fon va bahoning bir tomonlaligi
Hozirgi tahlilni toʻgʻri oʻqish uchun orqa fon muhim. Anthropic oʻz tahlilida eslatishicha, Claude Mythos Preview — avtonom, boshidan oxirigacha kiber ekspluat qura oladigan birinchi sunʻiy intellekt modeli — taxminan besh oy oldin eʻlon qilingan va Project Glasswing orqali cheklangan kirishda tarqatilgan. Ushbu dastur doirasida ishonchli kiber himoyachilar muhim dasturiy taʻminotdagi 10 000 dan ortiq zaiflikni topgan — yaʻni hujumchilar shunday quvvatli modellarga ega boʻlishidan oldin himoya tomoniga ustunlik berish maqsad qilingan. Anthropicʻning taʻkidlashicha, «endi bu modellar yetib keldi».
Tahlilni toʻliq tushunish uchun uning muallifligi ham muhim. Sinovlarni oʻtkazgan va xulosalarni eʻlon qilgan — Anthropic, yaʻni baholanayotgan modelning toʻgʻridan-toʻgʻri raqibi. Kompaniya oʻzining Mythos Preview modeli cheklangan kirishda, himoya choralari bilan tarqatilganini, GLM-5.3 esa ochiq ogʻirliklarda, «sezilarli cheklovlarsiz» chiqarilganini taʻkidlaydi. Raqamlar va usullar tavsifi faktik, ammo ularning talqini — «sezilarli oʻzgarish» degan xulosa — bir tomonning bahosi sifatida oʻqilishi kerak.
Shuningdek, Anthropic tahlilda topilgan zaifliklar haqida dastur taʻminotchilarga xabar berilganini qayd etadi — yaʻni sinov jarayonida aniqlangan muammolar masʻuliyatli oshkor qilish tartibi boʻyicha ishlab chiquvchilarga yetkazilgan. Bu amaliyot kiberxavfsizlik tadqiqotlarida standart hisoblanadi: tadqiqot muhitida topilgan zaiflik avval uni tuzata oladigan tomonga aytiladi, ommaga keyin eʻlon qilinadi.