Reflection AI 2026-yil 5-oktabrda oʻzining birinchi ochiq vaznli chegara modeli Beamʻni eʻlon qildi. Kompaniya modelni Xitoyning DeepSeek, Qwen va Z.ai ochiq modellariga Gʻarb javobi sifatida taqdim etmoqda. Beam — matnli ekspertlar aralashmasi (MoE) arxitekturasi: jami 501 milliard parametr, shundan 23 milliardi faol; 23,8 trillion tokenda oldindan oʻqitilgan, kontekst oynasi 1 million token. Model kodlash, mulohaza yuritish va agentli vazifalar uchun yuqori hisoblashli reinforcement learning bilan oʻqitilgan, tarqatish esa giper-skeylerlar va neokloudlar orqali amalga oshiriladi. Modelning nishoni — token boshiga koʻproq intellekt berib, korporativ kodlash va agentli ish yuklarini arzonroq bajarishdir.
Model tavsifi
Beam — toʻliq matnli model: tasvir yoki boshqa modalitetlarni bevosita qayta ishlamaydi, ammo ular matn sifatida tasvirlanganda ishlay oladi. Arxitektura asosi — sayyoh MoE tuzilishi: oʻzaro bogʻlangan mahalliy va global eʻtibor qatlamlari, mayda granulali yoʻnaltirilgan ekspertlar va bir tekis yuklanishni taʻminlovchi muvozanatlash mexanizmlari. Oldindan oʻqitish jarayonida 23,8 trillion xilma-xil, saralangan token — veb manbalari va litsenziyalangan shaxsiy maʻlumotlar toʻplamidan ishlatilgan. Kompaniyaning maʻlum qilishicha, Beam Base yakuniy modeli oʻxshash oʻlchamdagi mavjud ochiq baza modellari bilan teng yoki undan yuqori natija koʻrsatgan.
Yuqori hisoblashli reinforcement learning
Beamʻning asosiy farqi — mulohaza va agentli qobiliyatlarni rivojlantirishga qaratilgan ulkan miqyosdagi reinforcement learning. Reflection blogi maʻlumotlariga koʻra, RL jarayonida 10 500 ta NVIDIA GB300 GPUʻda toʻrt hafta davomida 100 milliondan ortiq rollout yaratilgan, baholashda taxminan 1,3 milliard sandbox ishlatilgan. Kompaniya bu hajmni "ochiq laboratoriyalar orasidagi eng yirik RL yugurishlardan biri" deb ataydi. Oʻquv davomida bir millionga yaqin yuqori sifatli kodlash, agentli va STEM muhitlaridan iborat havza tuzilgan; vazifa sifati har bosqichda sinovdan oʻtkazilgan.
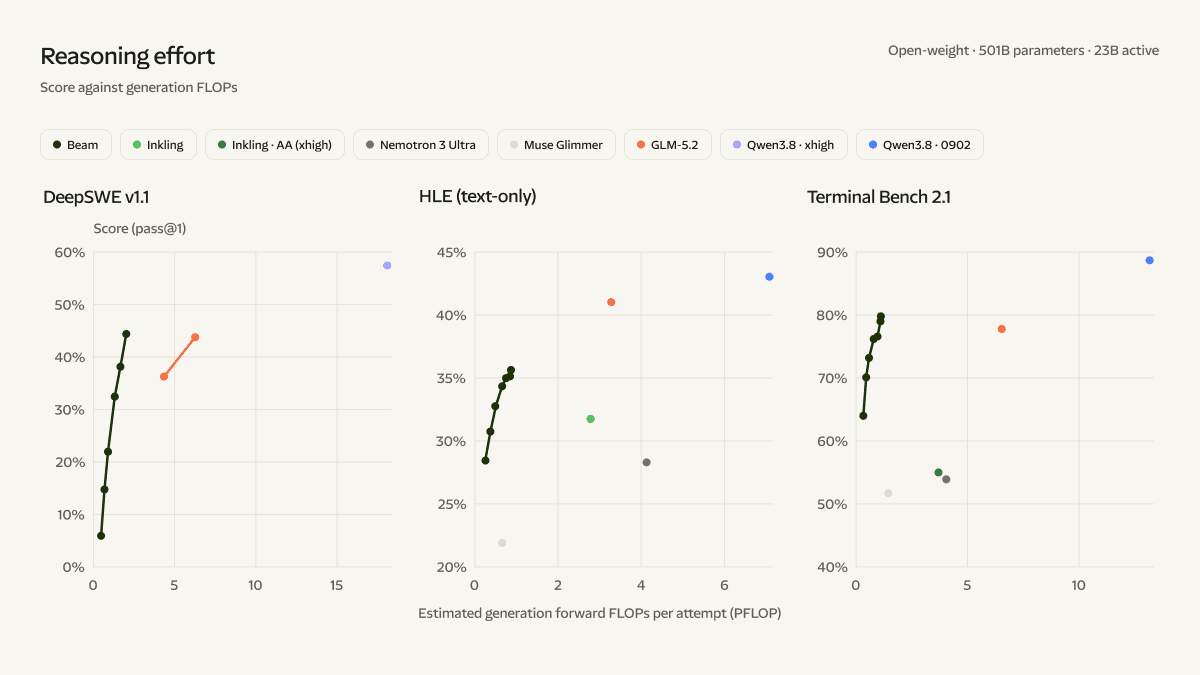
Model "reasoning effort" parametri orqali fikrlash chuqurligini nazorat qiladi: past sozlama qisqa javob beradi, yuqori sozlama murakkab vazifalarda uzoqroq fikrlash imkonini beradi. Kompaniyaning taʻkidlashicha, RL boshida model qisqaroq fikrlash bilan ham samaraliroq yechim topishni oʻrgangan, keyinchalik esa kuchliroq agentli qobiliyatlar rivojlangan sari javob uzunligi yana oʻsgan — ammo qoʻshimcha tokenlar yangi samaradorlik oʻsishini taʻminlagan.
Benchmark natijalari
Kompaniya Beamʻning ilgʻor mulohaza benchmarklarida Z.aiʻning GLM-5.2 modeli bilan teng natija qayd etganini, inferensda esa 3–4 marta kamroq hisoblash sarflaganini daʻvo qilmoqda. Kodlash benchmarklarida eʻlon qilingan koʻrsatkichlar: SWE Bench Verified boʻyicha 80,9%, Terminal Bench 2.1 boʻyicha 80,1%, SWE Bench Pro v2-Hard boʻyicha 77,2%. DeepSWE v1.1 boʻyicha 44,4% natija GLM-5.2 (44,0%) bilan deyarli teng. Reflection blogining taʻkidlashicha, Qwen 3.8-Max kabi 2 trilliondan katta parametrli modellarga nisbatan samaradorlik farqi yanada sezilarli.
"Birgalikda bu saʻy-harakatlar inferens hisoblash samaradorligi bilan birga raqobatbardosh ochiq vaznli ishlashni berdi." — Reflection AI blogi
TechCrunch bu daʻvolar hali mustaqil tekshiruvdan oʻtmaganini eslatadi. Shuningdek, blog jadvalidagi taqqoslashlarda Kimi K3 va DeepSeek V4.1 Flash kabi modellar ayrim benchmarklarda oldinda ekani koʻrinadi — Beamʻning asosiy ustunligi mutlaq yetakchilik emas, balki inferens samaradorligidir.
Umumlashuvchan qobiliyatlar
Kompaniyaning maʻlum qilishicha, RL oʻqitish modeli oʻrganilgan vazifalardan tashqariga chiqadigan agentli qobiliyatlarni shakllantirgan. Masalan, oʻquv aralashmasida veb-koʻrik vazifalari boʻlmaganiga qaramay, model koʻrik koʻrsatkichlarida izchil oʻsish koʻrsatgan. Veb kirish imkoniyati berilganda Beam oʻz-oʻzidan boshqa katta til modellarini qidirish va soʻrashni, hujjatlarni oʻqish uchun OCR APIʻlaridan foydalanishni oʻrgangan. Kompaniya namoyishlarida model ommaviy maʻlumotlar asosida jonli Nyu-York metrosi panelini yaratish, interaktiv ilovalar qurish va Gemma-4 uchun Text2SQL vazifasida nozik sozlash daftarini tayyorlash kabi vazifalarni bajargani koʻrsatilgan.
Tarqatish rejasi
Ogʻirliklar, texnik hisobot, model kartasi va ishlab chiquvchi artefaktlari shu oyning oʻzida chiqariladi. Ishga tushirilganda Beam giper-skeylerlar va neokloudlar orqali tarqatiladi, ochiq kodli kutubxonalar bilan integratsiyalar ham bir vaqtda tayyor boʻladi. Hozirda Beam yakuniy red-team sinovlari va baholashlardan oʻtmoqda, erta kirish uchun roʻyxatdan oʻtish ochilgan.
Kompaniya ortida
Reflection AI 2024-yilda Google DeepMindʻning ikki sobiq tadqiqotchisi tomonidan asos solingan. Kompaniya Nvidia, Sequoia va Lightspeed ishtirokida taxminan 4,7 milliard dollar sarmoya jalb qilgan, baholash 25 milliard dollarga yetgan. Shuningdek, SpaceX va Nebius bilan 2029-yilgacha Nvidia GB300 imkoniyatini taʻminlash boʻyicha 7 milliard dollardan ortiq hisoblash bitimlari imzolangan.