5 октября 2026 года компания Reflection AI анонсировала Beam — свою первую открытую модель с пограничными возможностями. Компания представляет модель как западный ответ открытым моделям Китая — DeepSeek, Qwen и Z.ai. Beam — смесь экспертов (MoE) только для текстовых задач: всего 501 млрд параметров, из которых активны 23 млрд; предварительно обучена на 23,8 трлн токенов, контекстное окно — 1 млн токенов. Модель обучена с применением высокопроизводительного обучения с подкреплением (reinforcement learning) для программирования, рассуждений и агентных задач, а распространение будет идти через гиперскейлеров и неоклауды. Цель модели — давать больше интеллекта на каждый токен, чтобы корпоративное программирование и агентные рабочие нагрузки обходились дешевле.
Описание модели
Beam — полностью текстовая модель: изображения и другие модальности напрямую она не обрабатывает, но может работать с ними, если они описаны текстом. В основе архитектуры — мобильная MoE-структура: взаимосвязанные локальные и глобальные слои внимания, мелкозернистые направленные эксперты и механизмы балансировки, обеспечивающие равномерную нагрузку. В ходе предварительного обучения было использовано 23,8 трлн разнообразных, отобранных токенов — из веб-источников и лицензированных частных наборов данных. По заявлению компании, итоговая модель Beam Base показала результаты на уровне или выше существующих открытых базовых моделей сопоставимого размера.
Масштабное обучение с подкреплением
Главное отличие Beam — масштабное обучение с подкреплением, направленное на развитие рассуждений и агентных способностей. По данным блога Reflection, в ходе RL-процесса на 10 500 GPU NVIDIA GB300 за четыре недели было создано более 100 млн роллаутов, а для оценки использовано около 1,3 млрд песочниц. Компания называет этот объём «одним из крупнейших RL-прогонов среди открытых лабораторий». В процессе обучения был собран пул из почти миллиона высококачественных сред для программирования, агентных и STEM-задач; качество задач проверялось на каждом этапе.
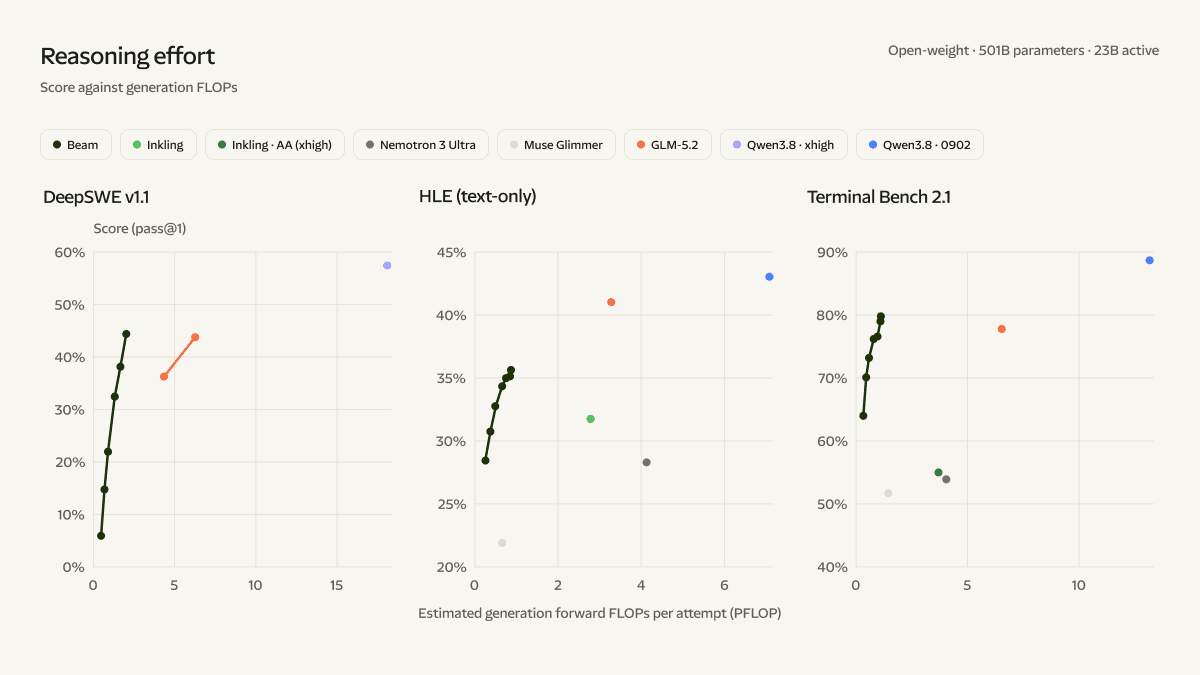
Параметр «reasoning effort» позволяет контролировать глубину рассуждений модели: низкая настройка даёт короткий ответ, высокая — позволяет дольше рассуждать над сложными задачами. По словам компании, в начале RL модель научилась находить более эффективные решения с более коротким рассуждением, а затем, по мере развития более сильных агентных способностей, длина ответов снова выросла — но дополнительные токены обеспечили новый прирост эффективности.
Результаты бенчмарков
Компания заявляет, что Beam показала результаты на уровне модели GLM-5.2 от Z.ai в продвинутых бенчмарках рассуждений, затратив при этом в 3–4 раза меньше вычислений на инференсе. Опубликованные показатели по бенчмаркам программирования: SWE Bench Verified — 80,9%, Terminal Bench 2.1 — 80,1%, SWE Bench Pro v2-Hard — 77,2%. Результат DeepSWE v1.1 — 44,4% — практически на уровне GLM-5.2 (44,0%). Как подчёркивает блог Reflection, разрыв в эффективности ещё заметнее по сравнению с моделями с более чем 2 трлн параметров, такими как Qwen 3.8-Max.
«Вместе эти усилия дали конкурентоспособную производительность при открытых весах и эффективность инференса по вычислительным затратам». — блог Reflection AI
TechCrunch напоминает, что эти заявления ещё не прошли независимую проверку. Также из таблиц сравнений в блоге видно, что такие модели, как Kimi K3 и DeepSeek V4.1 Flash, опережают в некоторых бенчмарках, — главное преимущество Beam не абсолютное лидерство, а эффективность инференса.
Обобщающие способности
По заявлению компании, RL-обучение сформировало у модели агентные способности, выходящие за рамки задач, на которых она училась. Например, несмотря на отсутствие в учебной смеси задач веб-навигации, модель показала стабильный рост показателей навигации. Получив доступ к вебу, Beam самостоятельно научилась искать другие большие языковые модели и обращаться к ним, использовать OCR API для чтения документов. В демонстрациях компании модель выполняла такие задачи, как создание живого табло метро Нью-Йорка на основе публичных данных, построение интерактивных приложений и подготовка тонко настроенного ноутбука для задачи Text2SQL на Gemma-4.
План выпуска
Веса, технический отчёт, карточка модели и артефакты для разработчиков будут выпущены в этом же месяце. При запуске Beam будет распространяться через гиперскейлеров и неоклауды, интеграции с открытыми библиотеками будут готовы одновременно. Сейчас Beam проходит финальные red-team-тесты и оценки, регистрация для раннего доступа открыта.
О компании
Reflection AI была основана в 2024 году двумя бывшими исследователями Google DeepMind. Компания привлекла около 4,7 млрд долларов инвестиций при участии Nvidia, Sequoia и Lightspeed, оценка достигла 25 млрд долларов. Также подписаны вычислительные соглашения на сумму более 7 млрд долларов со SpaceX и Nebius по обеспечению мощностей Nvidia GB300 до 2029 года.